词嵌入:获取嵌入表示#
本节要点:
- 获取嵌入表示的两种方法:要么用降维技术(典型如 PCA)把高维结构压进低维空间,要么把嵌入层放进神经网络、随目标任务一起训练。
- 嵌入层:隐藏层大小为 $d$ 时,这一层就是嵌入层;$d$ 既是隐藏层的节点数,也是嵌入空间的维度数。
- 静态嵌入的软肋:一个词在向量空间里只占一个点,orange 既指颜色又指水果,必然顾此失彼。
- 上下文嵌入:让同一个词拥有多个向量,把周边词语的信息一并编码进来,ELMo、BERT、Transformer 走的都是这种方法。
在前面几节内容中,我们把嵌入空间、静态嵌入和交互练习都过了一遍,但还有一个最基本的问题没有回答:嵌入表示到底是怎么造出来的? 在本节内容中将会介绍获取嵌入的几种方式,以及如何把静态嵌入转换为上下文嵌入。
降维技术获取嵌入表示#
先看第一种方法:从高维空间里“压”出一个低维空间。
其实有不少数学技术能把高维空间里的重要结构捕获到低维空间里去,从理论上说,这些技术中的任何一种都可以用来为机器学习系统创建嵌入表示。
拿主成分分析(PCA)来说,它就曾被用来创建词嵌入向量:给定一组实例(比如词袋向量),PCA 会尝试找出那些高度相关、可以被合并成单一维度的维度。
MLWM: 通过类似降维这样的方式获得的嵌入表示效果并不太好,因此也极少使用,主要是通过神经网络来训练得到。
在神经网络中训练嵌入表示#
接下来是第二种方法,也是更贴近工程实践的一条:从神经网络中训练得到嵌入表示。
你完全可以在为目标任务训练神经网络的同时创建一个嵌入层,这样做的好处是,最后得到的词嵌入表示会非常贴合你自己的系统;代价则是,它可能比单独训练嵌入表示更耗时。
一般来说做法是这样的:在神经网络里建一个大小为 $d$ 的隐藏层,把它指定为嵌入层,这里的 $d$ 既表示隐藏层中的节点数,也表示嵌入空间中的维度数。此时,这个嵌入层可以与任何其他特征和隐藏层组合在一起。同任何深度神经网络一样,这些参数会在训练过程中被优化,以最小化网络输出层中各个节点的损失。最终,当网络结束训练以后,也就同时得到了词嵌入表示。
MLWM: 如下图所示,左侧输入层为上下文词的独热编码表示形式,其中$|\mathcal{V}|$表示词表的长度;中间为隐藏层,每一行表示根据对应上下文词独热编码索引得到的输入词向量表示,这也被形象的称为词嵌入(Word Embedding);输入层和隐藏层之间的权重矩阵$V\in \mathbb{R}^{|\mathcal{V}|\times n}$为输入词向量矩阵,其中第$i$行$v_i$表示词表中第$i$个词$w_i$对应的输入词向量,而这也模型训练完毕后每个词真正的词向量表示;隐藏层与输出层之间的权重矩阵$U\in \mathbb{R}^{n\times |\mathcal{V}|}$为输出词向量矩阵,其中第$i$列$u_i$表示词表中第$i$个词$w_i$对应的输出词向量,用于同$v_i$计算得到对应的条件概率分布。
CBOW 模型网络结构图 更多相关内容可以参加 Word2Vec原理:词向量训练与语义表示方法 中的介绍。

还是回到第一节那个美食推荐的例子:我们的目标,是根据用户当前喜欢的食物,预测他们还会喜欢哪些新食物。
具体可以这么做:先收集用户最喜欢的五种食物的更多数据;再把这个任务建模成监督学习问题,也就是把其中四种设成特征数据,随机留下第五种作为模型要预测的正标签,用 softmax 损失来优化模型的预测结果。
在训练过程中,神经网络会为第一个隐藏层(也就是嵌入层)里的节点学到最优权重。举个例子,如果第一个隐藏层里放了三个节点,模型可能会认定食物最相关的三个维度是三明治度、甜点度和液体度。图 7 展示的就是“热狗”的独热编码被转换成一个三维向量的过程。

要提醒一句的是:训练过程中嵌入层的权重会被不断优化,让相似样本的嵌入向量彼此靠近。但前面说的“三明治度、甜点度、液体度”只是教学用的示意,真实模型为它的嵌入选出来的维度,很可能不像这个例子这样直观、这样好解释。
上下文嵌入#
有了嵌入,我们再来处理静态嵌入最麻烦的一个软肋。
word2vec 静态嵌入向量有一个局限:同一个词,在不同上下文里可能意思完全不同。“Yeah” 单独出现是一种意思,放进 “Yeah, right.” 里就正好相反。“Post” 就更夸张了——可以是"邮件",也可以是"放入邮件"、“耳环托”、“赛马结束时的标记”、“后期制作”、“支柱”、“张贴通知”、“驻扎警卫或士兵”、“之后”,还有很多别的可能。
而在静态嵌入下,每个词都只由向量空间里的单个点来表示,哪怕它其实有好几种含义。
在上一节的练习里,你已经发现了静态嵌入在 orange 这个词上的局限——它既可以是颜色,也可以是一种水果。因此,如果只用单一静态嵌入的话,在 word2vec 数据集上训练出来的 orange,永远离其他颜色更近,而不是离 juice 更近。
上下文嵌入表示正是为解决这个局限而生的:同一个词可以由多个嵌入来表示,这些嵌入既包含词本身的信息,也把周边词语的信息吸收进来。换句话说,数据集里每一句包含 orange 的句子,都会给这句子里的 orange 配上一个不同的嵌入。
比如 ELMo 这类方法,做法是先取样本的静态嵌入(比如句子里某个词的 word2vec 向量),再用一个“纳入了周边词语信息”的函数把它变换一下——变换出来的,就是上下文嵌入。
点击查看上下文嵌入的详细说明
ELMo:静态嵌入会与从其他层提取的嵌入汇总在一起,这些嵌入分别编码了句子从头到尾、从尾到头的两种读法。
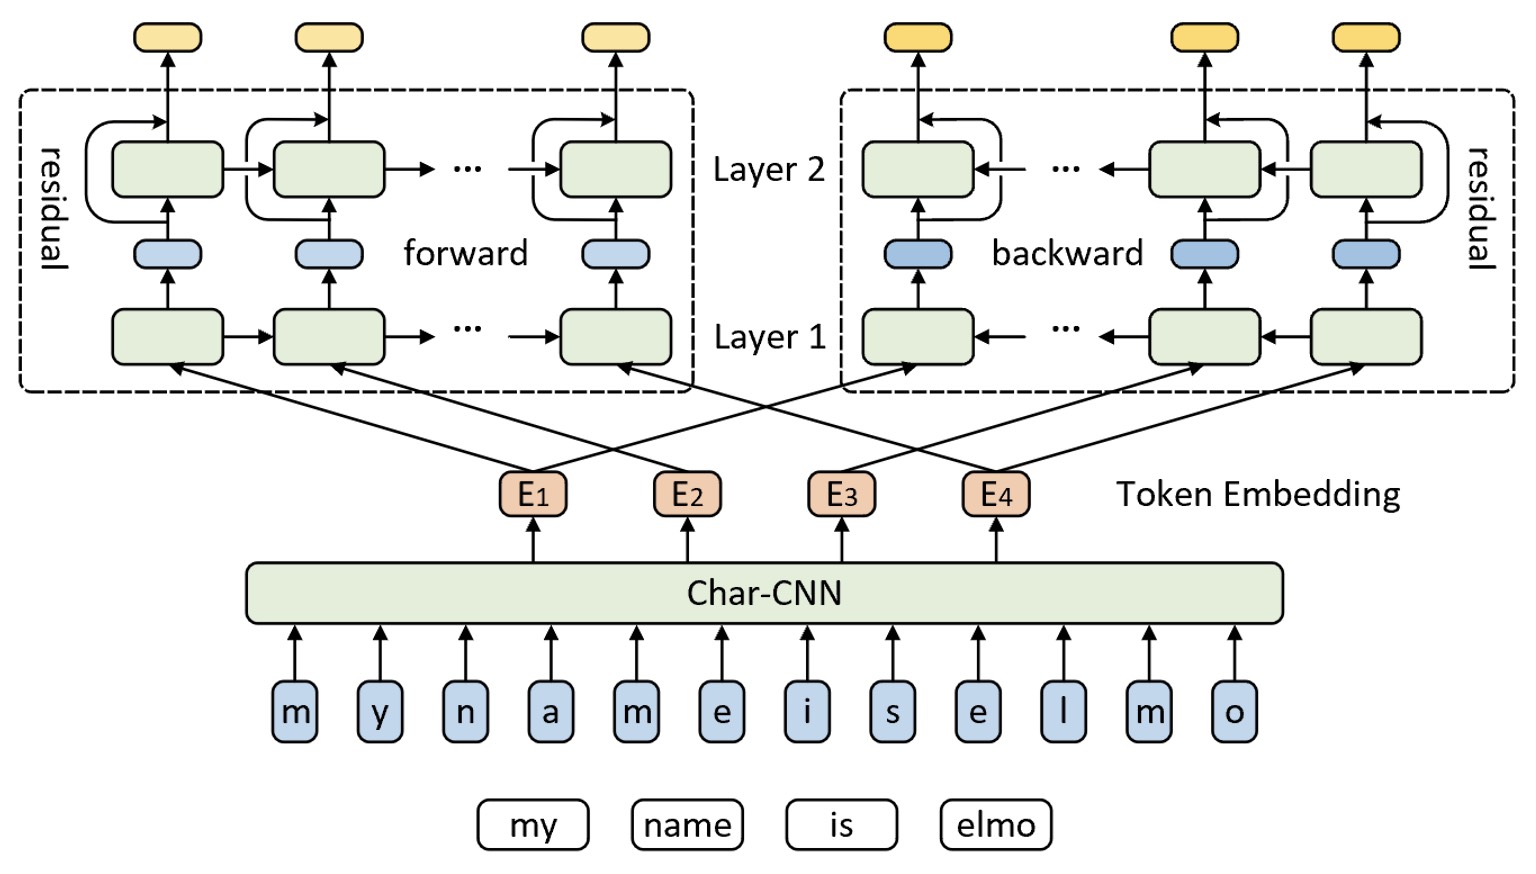
ELMo网络结构图 更多相关内容可以参见 ELMo原理:上下文词向量与动态表示方法 中的内容。
BERT:把模型作为输入的那段序列的一部分给遮盖掉。

BERT网络模型细节图 更多相关内容可以参见 BERT 原理与预训练教程:Masked LM 与 Next Sentence Prediction 图解 中的内容。
Transformer:用自注意力层来权衡序列里其他词与每个词的相关性;还会把位置嵌入矩阵(位置编码)里对应的那一列,逐元素加到之前学好的每个 token 嵌入上,生成输入嵌入,再喂给模型的其余部分去做推理。这份输入嵌入对每段不同的文本序列都是独一无二的,它就是上下文嵌入。

Transformer网络结构图 更多相关内容可以参见 Multi-Head Attention 多头注意力机制图解教程:从动机到 Q/K/V 与多头分割原理 中的内容。
顺带说一句,上面这几个都是语言模型,但上下文嵌入在别的生成任务(比如图片)里同样有用。把一匹马照片中每个像素的 RGB 值做成嵌入,再配上表示每个像素位置的位置矩阵、以及对周边像素的某种编码——这比只有 RGB 值的原始静态嵌入能给模型更多信息,也就构成了图片的上下文嵌入。
关键术语:
- 词袋(Bag of words)
- BERT
- 嵌入层(Embedding layer)
- 嵌入向量(Embedding vector)
- 神经网络(Neural network)
- 位置编码(Positional encoding)
- Softmax