为什么 Transformer 中使用 LayerNorm 而不是 BatchNorm?#
在深度学习模型中,归一化(Normalization) 是一个非常重要的技巧。它不仅能够稳定训练过程,还能加速收敛,提升模型泛化能力。我们最熟悉的可能是 Batch Normalization (BatchNorm),但在 Transformer 等 NLP 模型中,我们却几乎只看到 Layer Normalization (LayerNorm) 的身影。
那么问题来了:为什么 Transformer 更倾向于使用 LayerNorm,而不是 BatchNorm 呢?
1. BatchNorm 与 LayerNorm 基本原理#
Batch Normalization
思想:对 mini-batch 内同一特征维度上的激活值进行归一化。
计算方式:对每一层的某个特征维度,计算 batch 内的均值和方差:
$$ \hat{x} = \frac{x - \mu_{\text{batch}}}{\sigma_{\text{batch}}} $$特点: 依赖于 batch size ,在 CNN 中非常有效,因为图像任务通常 batch size 较大,且不同样本之间的分布差异不大。
Layer Normalization
思想:对同一样本内的所有特征维度进行归一化。
计算方式:在每个 token 的隐藏向量上计算均值和方差:
$$ \hat{x} = \frac{x - \mu_{\text{layer}}}{\sigma_{\text{layer}}} $$特点: 不依赖 batch size,独立归一化,适合序列建模。
2. BatchNorm 与 LayerNorm 区别#
由此可知,批归一化需要先计算一个小批量数据中每个通道上所有样本特征图的均值和方差,然后再根据对应的公式进行标准化。可见,此时小批量样本的数量便会影响均值和方差的估计结果。同时,在循环神经网络中由于每个样本的序列长度并不相同,如果使用批归一化进行标准化那么当模型推理时只要出现样本序列长度大于训练时最长的样本序列长度时,那么归一化过程将无法进行,因为此时需要对每个时间片的输出结果进行标准化并输入到下一个时刻中。除此之外,对于训练数据来说其长度越长则对应的样本数量将会越少,如果仍旧使用批归一化这类跨样本的归一化方法那么极端情况下将会出现归一化失真的情况。
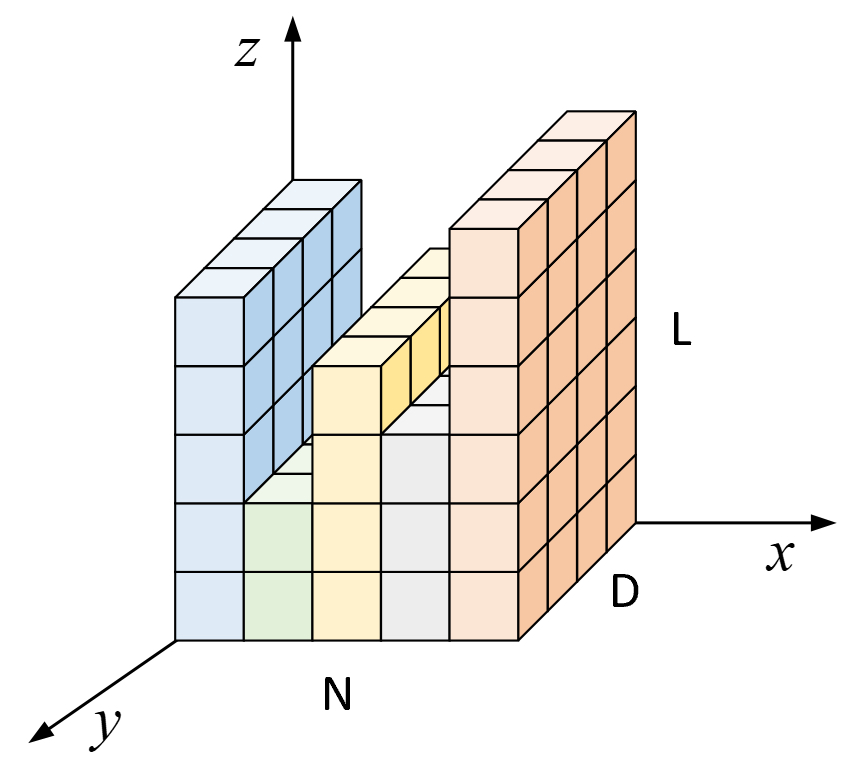
如图1所示为文本序列批归一化序列图,其$x$轴、$y$轴和$z$轴分别表示小批量样本数量、词向量维度和样本序列长度,即图6-15中有5个样本,从左到右其长度分别的5、2、4、3和6,且每个词的维度为4维。如果此时对于整个小批量样本同时在$z$轴这个维度上采用批归一化进行标准化,那么在对进行第3个词的位置进行标准化时第2个样本便不会参与,进一步在对第6个词的位置进行标准化时便只有第5个词参与,而这便会影响整个归一化结果。退一步来说,即便通过这样的方式进行标准化,那么当测试样本的长度大于6时,该位置便没有对应的批归一化模型参数。
由于跨样本间进行标准化会受到上述因素的影响,因此层归一化提出了以每个样本为独立单位进行标准化的思想。具体地,对于普通的前馈神经网络来说,以每个样本当前层的所有神经元为整体进行标准化;对于卷积神经网络来说,以每个样本在当前层的所有特征通道为整体进行标准化;对于循环神经网络来说,则是以每个样本在当前时刻的输出向量为整体进行标准化,即图6-15中$y$˙轴所在的维度。
从归一化的计算过程来看,层归一化同批归一化的计算公式类似,即先计算均值和方差,然后进行标准化,最后再进行缩放和平移,唯一的差别在于两者选择归一化的维度不同,但也有研究表明缩放和平移操作反而会对于层归一化有害 [3]。如图6-16所示便是两者在对卷积特征进行归一化时维度选择的差异之处。
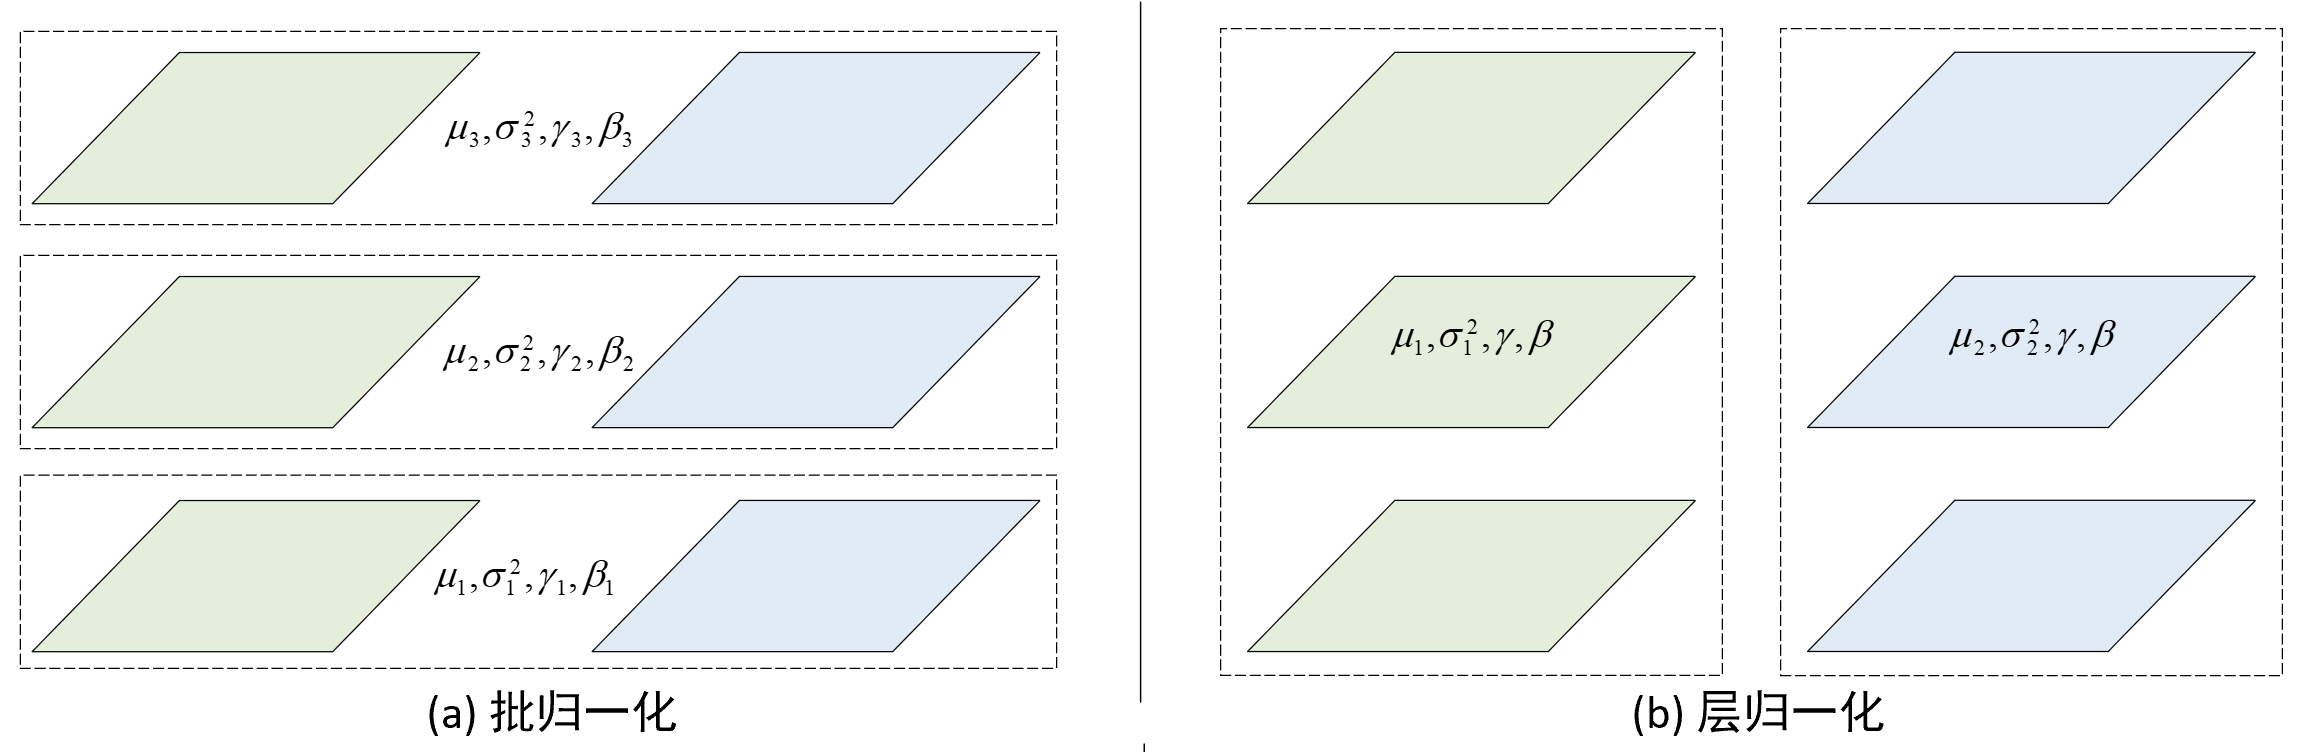
如图2所示,左右两边为分别是批归一化和层归一化的归一化维度示意图,其一共包含有2个样本和3个特征通道。从图2(a)可以看出,批归一化在进行标准化时是将所有小批量样本看成的一个整体,并逐一对每个通道进行标准化,且每个通道有各自独立的均值$\mu_i$、方差$\sigma^2_i$和权重参数$\gamma_i,\beta_i$(4个值均为标量);对于图2(b)中的层归一化来说,它在进行标准化时是将每个样本看做一个整体,并同时对所有通道进行标准化,且每个样本均有各自独立的均值$\mu_i$和方差$\sigma^2_i$(2个值均为标量)但共享权重参数$\gamma,\beta$(2个值均为向量,维度为$p\times q\times c$,分别表示特征图的长、宽和通道数)。